Object storage vs block storage: o que é e quando usar
Object storage guarda arquivos como objetos acessados por HTTP (S3); block storage é o disco da VM. Veja diferenças, custos e quando usar cada um.
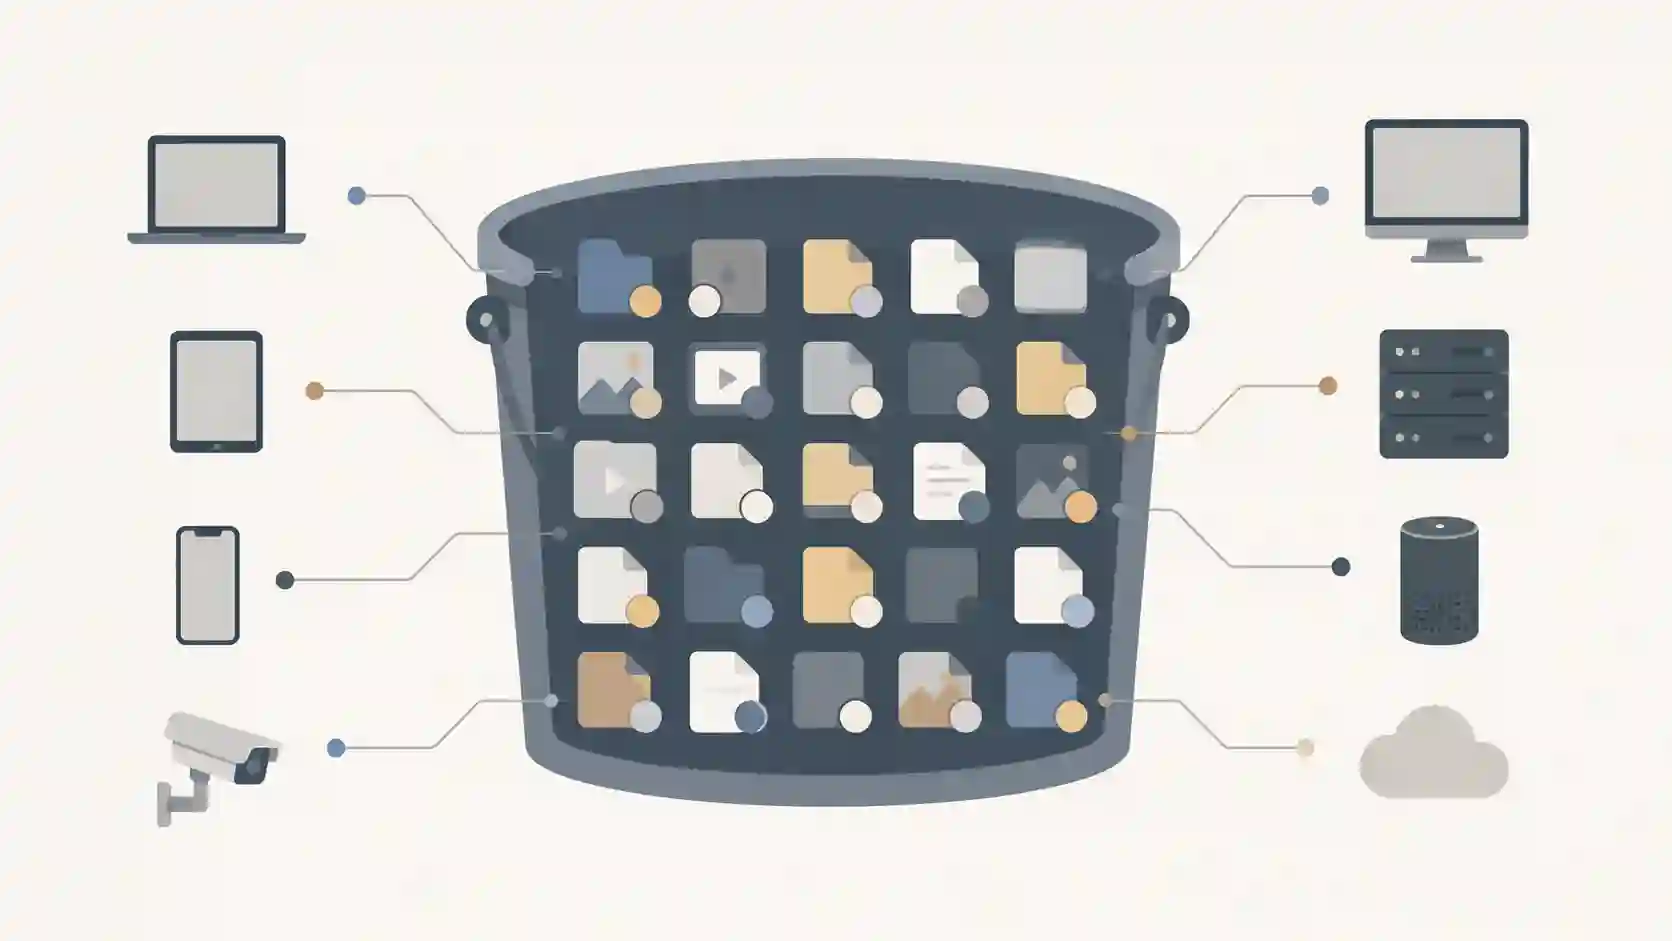
Você subiu a aplicação para a nuvem, o tráfego cresceu, e o disco da máquina virtual está cheio de uploads de usuário: fotos de perfil, PDFs, vídeos. A saída óbvia parece ser aumentar o disco. Só que esse disco vive amarrado a uma instância, a segunda instância atrás do load balancer não enxerga os arquivos da primeira, e o backup de milhões de arquivinhos vira um projeto à parte. É esse problema que object storage resolve, e é por isso que ele virou o jeito padrão de guardar arquivo na nuvem.
Em duas linhas: object storage guarda cada arquivo como um objeto (dados, metadados e uma chave) acessado por uma API HTTP, como o Amazon S3. Block storage é o disco da máquina virtual, que o sistema operacional monta e formata, e file storage é uma pasta compartilhada pela rede via NFS ou SMB. Object ganha em escala e acesso por URL, block em latência, file em compartilhar um sistema de arquivos entre máquinas. O resto deste post detalha a diferença, mostra como servimos as imagens deste blog e corrige alguns mitos que ainda circulam.
Object storage vs block storage vs file storage
A tabela que resolve a maioria das dúvidas:
| Object storage | Block storage | File storage | |
|---|---|---|---|
| Unidade | Objeto: dados + metadados + chave | Blocos de tamanho fixo | Arquivos numa árvore de pastas |
| Acesso | API HTTP (S3 e similares) | Disco montado e formatado pelo SO | Compartilhamento de rede (NFS, SMB) |
| Quem enxerga | Qualquer cliente com credencial ou URL | Em geral uma VM por vez | Várias máquinas ao mesmo tempo |
| Escala | Praticamente ilimitada, sem provisionar | Limitada ao tamanho do volume | Limitada pelo serviço, cresce sob demanda em vários |
| Latência | Maior (uma requisição HTTP por operação) | Muito baixa | Intermediária |
| Escrita parcial | Em geral não: reescreve o objeto | Sim, bloco a bloco | Sim, dentro do arquivo |
| Uso típico | Uploads, mídia, backup, logs, data lake | Banco de dados, disco de sistema | Diretório compartilhado, apps legados |
| AWS | S3 | EBS | EFS (e FSx) |
| Azure | Blob Storage | Managed Disks | Azure Files |
| Google Cloud | Cloud Storage | Persistent Disk / Hyperdisk | Filestore |
Block storage é o "HD" da máquina: o sistema operacional enxerga um disco, lê e escreve blocos em qualquer posição, e isso é o que um banco de dados precisa. O Postgres, por exemplo, guarda cada banco numa pasta dentro de base/ no diretório de dados e reescreve páginas de 8 kB no meio desses arquivos o tempo todo (documentação do layout de arquivos). Esse padrão de escrita aleatória não combina com object storage.
File storage resolve outro problema: várias máquinas montando a mesma pasta. É o que você usa quando um software legado espera um caminho de sistema de arquivos e você precisa dele em mais de uma instância.
Object storage troca latência por escala e durabilidade. A AWS diz que o S3 é projetado para mais de 99,999999999% de durabilidade, os famosos onze noves (classes de armazenamento do S3), replicando os dados em vários dispositivos. É imbatível para guardar volume de arquivo não estruturado acessado por HTTP.
O que é object storage, na prática
Cada objeto carrega três coisas juntas:
- Os dados: o conteúdo do arquivo (imagem, vídeo, JSON, dump de banco).
- Metadados: os do sistema (tipo de conteúdo, tamanho, data, ETag,
Cache-Control) e os seus, pares chave/valor comoownerid=42. - A chave: o identificador único dentro do bucket, que é o endereço para buscar o objeto.
Os objetos ficam em buckets, contêineres lógicos com nome, região e políticas de acesso próprios. O detalhe que confunde quem vem de sistema de arquivos: no S3 padrão não existem pastas de verdade. O namespace é plano. Quando você vê fotos/2026/perfil.jpg, isso é a chave inteira, uma string com barras que o console exibe como se fosse diretório. Listar "a pasta" fotos/ é listar as chaves que começam com esse prefixo.
Como o acesso funciona: tudo é HTTP
Você não monta disco nem abre arquivo pelo sistema operacional; você faz requisições HTTP. PUT grava um objeto, GET lê, DELETE apaga, HEAD traz só os metadados. Na prática você usa um SDK. Em Node, com o AWS SDK v3:
import { S3Client, PutObjectCommand, GetObjectCommand } from "@aws-sdk/client-s3";
import { getSignedUrl } from "@aws-sdk/s3-request-presigner";

const s3 = new S3Client({ region: "us-east-1" });

await s3.send(new PutObjectCommand({
  Bucket: "meu-bucket",
  Key: "fotos/2026/perfil.jpg",
  Body: fileBuffer,
  ContentType: "image/jpeg",
  Metadata: { ownerid: "42" },
}));

// link temporário (5 minutos) para o browser baixar direto do bucket privado
const url = await getSignedUrl(
  s3,
  new GetObjectCommand({ Bucket: "meu-bucket", Key: "fotos/2026/perfil.jpg" }),
  { expiresIn: 300 },
);
Rodei esse código (SDK 3.1164, Node 22) contra um servidor compatível com S3 local em Docker: o upload, o HeadObject devolvendo image/jpeg e o metadado, e o GET pela URL pré-assinada respondendo 200. Dois detalhes que aparecem cedo na vida real: o S3 guarda as chaves de metadado do usuário em minúsculas (documentação de metadados), então ownerId volta como ownerid; e a API de objetos não busca por metadado, não existe "listar objetos onde ownerid=42". (A AWS tem um recurso à parte, o S3 Metadata, que copia metadados para tabelas Apache Iceberg consultáveis pelo Athena; é outro serviço, com outra cobrança, não um WHERE no bucket.)
A URL pré-assinada é o jeito certo de dar acesso pontual a um bucket privado: um link com assinatura e prazo de validade, gerado no seu backend. Serve para download e também para upload direto do browser para o bucket, sem o arquivo passar pelo seu servidor.
Como tudo é HTTP, o mesmo objeto pode ser servido ao navegador, colocado atrás de uma CDN ou acessado de qualquer região sem montar volume nenhum.
Na prática: como servimos as imagens deste blog
As capas dos posts daqui ficam no Cloudflare R2, um object storage com API compatível com S3, servidas pelo domínio assets.quickeasy.tools. O script de upload usa o mesmo @aws-sdk/client-s3 do exemplo acima, só trocando o endpoint para o do R2 e a região para "auto".
Escolhemos o R2 por um motivo de fatura: ele não cobra egress. A página de preços diz que não há cobrança por banda de saída em nenhuma classe de armazenamento; em novembro de 2026 o armazenamento Standard sai a US$ 0,015 por GB-mês, com 10 GB-mês de cota grátis. Para um blog cujo custo é quase todo leitura de imagem, isso muda a conta.
A lição que custou um relatório do Lighthouse: as primeiras capas foram enviadas sem Cache-Control, e o domínio as servia sem max-age, com cf-cache-status: DYNAMIC. O Lighthouse reclamava do tempo de vida de cache das imagens ("efficient cache lifetime"). A correção foi gravar o cabeçalho no próprio objeto, no PutObject (CacheControl: "public, max-age=2592000", 30 dias, sem immutable porque a chave blog/{slug}/cover.webp é reaproveitada quando a capa muda). O detalhe que pega: metadado é do objeto e, no S3, não pode ser alterado depois do upload, só copiando o objeto com metadados novos. Corrigir o script não corrige o que já está no bucket: uma capa nossa enviada em junho ainda responde sem Cache-Control até alguém reenviá-la.
Object storage é o mesmo que S3?
Não. S3 é o serviço da Amazon; a API dele virou padrão de fato, e muita coisa fala "S3": Cloudflare R2, Backblaze B2, MinIO, Wasabi e a maioria dos provedores menores. Mas "compatível" tem graus, e duas afirmações comuns estão erradas:
- Azure Blob Storage não tem API S3 nativa. Ele usa a própria API REST, com SDKs próprios. Para apontar um código S3 para o Azure você precisa de um gateway de terceiros que traduz as chamadas, como S3Proxy ou produtos comerciais do Azure Marketplace.
- Google Cloud Storage fala S3 parcialmente. A XML API aceita "algumas" ferramentas e bibliotecas do S3, apontando para
https://storage.googleapis.comcom chaves HMAC. Funciona para o básico; não conte com cada recurso do S3.
Programar contra a API do S3 é uma boa aposta de portabilidade, desde que você teste no provedor de destino em vez de presumir.
Objetos são imutáveis? Quase sempre
No S3 padrão, no R2 e no GCS, a regra continua valendo: você não edita um pedaço do objeto nem o renomeia. Mudar um byte é reenviar o objeto inteiro; "renomear" é copiar para a chave nova e apagar a antiga, o que em massa vira custo e tempo.
Só que a regra deixou de ser universal:
- O S3 Express One Zone (directory buckets) aceita append de dados num objeto existente desde novembro de 2024 e ganhou a operação RenameObject, um rename atômico sem mover dados, em junho de 2025. Vale só para essa classe de armazenamento.
- O Azure tem três tipos de blob: block blobs (o objeto comum), append blobs, que só aceitam escrita no fim e servem para log, e page blobs, páginas de 512 bytes com leitura e escrita aleatória. Os discos de VM do Azure são construídos sobre page blobs.
Então a frase honesta é: na maioria dos serviços, e no S3 padrão, objeto é imutável; alguns serviços específicos já permitem append ou rename.
Erros comuns que custam caro
- Tratar o bucket como banco de dados.
ListObjectsV2devolve no máximo 1.000 chaves por chamada (referência da API) e só filtra por prefixo; não existe filtro por metadado nemWHERE. Guarde no seu banco os dados pesquisáveis (dono, tipo, data) com a chave do objeto e use o storage só para o conteúdo. - Deixar bucket público. O vazamento clássico foi bucket S3 aberto. Desde abril de 2023 a AWS liga o Block Public Access e desliga as ACLs em todo bucket novo, então hoje o vazamento costuma vir de alguém desligando essa proteção ou escrevendo uma bucket policy larga demais. Mantenha privado e use URL pré-assinada ou CDN com acesso controlado.
- Esquecer o egress. Guardar costuma ser barato; baixar é o que pesa na fatura dos provedores que cobram saída. Sirva por CDN com cache e, se o volume de leitura for alto, considere um provedor sem egress.
- Não definir
Cache-Controlno upload. Como vimos acima, é metadado do objeto. Esquecer no upload significa reprocessar depois. - Não ter versionamento nem lifecycle. Versionamento protege contra exclusão e sobrescrita acidentais; regras de lifecycle movem dados antigos para classes mais baratas ou os apagam sozinhas. Sem elas, o bucket de logs só cresce.
Perguntas frequentes
Qual a diferença entre object storage e block storage?
Block storage entrega um disco que o sistema operacional monta e formata, com latência muito baixa e escrita em qualquer posição; é o lugar de banco de dados e disco de VM. Object storage entrega objetos inteiros por API HTTP, com escala praticamente ilimitada e alta durabilidade; é o lugar de uploads, mídia e backup. Em uma frase: block para desempenho transacional, object para volume e acesso por URL.
Quando usar file storage em vez de object storage?
Quando várias máquinas precisam montar a mesma pasta e o software espera um caminho de sistema de arquivos, como aplicações legadas ou ferramentas que leem e escrevem arquivos no meio. Se o código pode falar HTTP com um SDK, object storage costuma ser mais barato e escalar melhor.
Object storage é o mesmo que S3?
Não. S3 é o serviço da Amazon, cuja API virou padrão de fato e é implementada por R2, B2, MinIO e outros. O Google Cloud Storage tem interoperabilidade parcial via XML API, e o Azure Blob Storage não fala S3 nativamente, exigindo um gateway.
Dá para rodar um banco de dados em cima de object storage?
Não como disco do banco: o padrão de escrita aleatória em páginas pequenas precisa de block storage. Object storage entra no banco como destino de backup, de arquivos WAL arquivados ou de dados frios consultados por engines analíticas que leem Parquet direto do bucket.
Object storage é para volume, block para latência
A decisão quase sempre se resolve com a tabela do início: arquivo acessado por HTTP e em volume vai para object storage, disco de banco e de sistema fica em block storage, e pasta compartilhada entre máquinas vai para file storage. Ao adotar object storage, deixe o bucket privado com URLs pré-assinadas, grave Cache-Control e Content-Type já no upload, mantenha os dados pesquisáveis no seu banco e ligue versionamento e lifecycle desde o primeiro dia. E desconfie de "compatível com S3" até testar no provedor de destino. Se a nuvem ainda está em discussão, o post sobre cloud pública, privada e híbrida ajuda a decidir onde esse storage vai morar.
O conteúdo editorial termina aqui. Para gerar chaves de objeto que não colidem entre instâncias, como uploads/{uuid}.jpg, eu uso o gerador de UUID do Quick Tools quando preciso de alguns valores na mão; em código, um UUID v7 gerado na aplicação resolve.
- 01 Nota do PageSpeed influencia o SEO? 100/100 e reprovado O Google não usa a nota de 0 a 100 do PageSpeed no ranking, e sim os Core Web Vitals de usuários reais. Veja por que dá 100/100 e reprova no campo.
- 02 Teste unitário vs teste de integração: diferença na prática A diferença entre teste unitário e de integração com exemplos de API e banco de dados: o que cada um pega, quanto custa e quando usar cada um no seu projeto.