Clean Architecture: vantagens, desvantagens e quando usar
Arquitetura limpa na prática: o que a Dependency Rule resolve, as armadilhas que viram overengineering (pastas, use cases vazios, DTOs) e quando ela compensa.
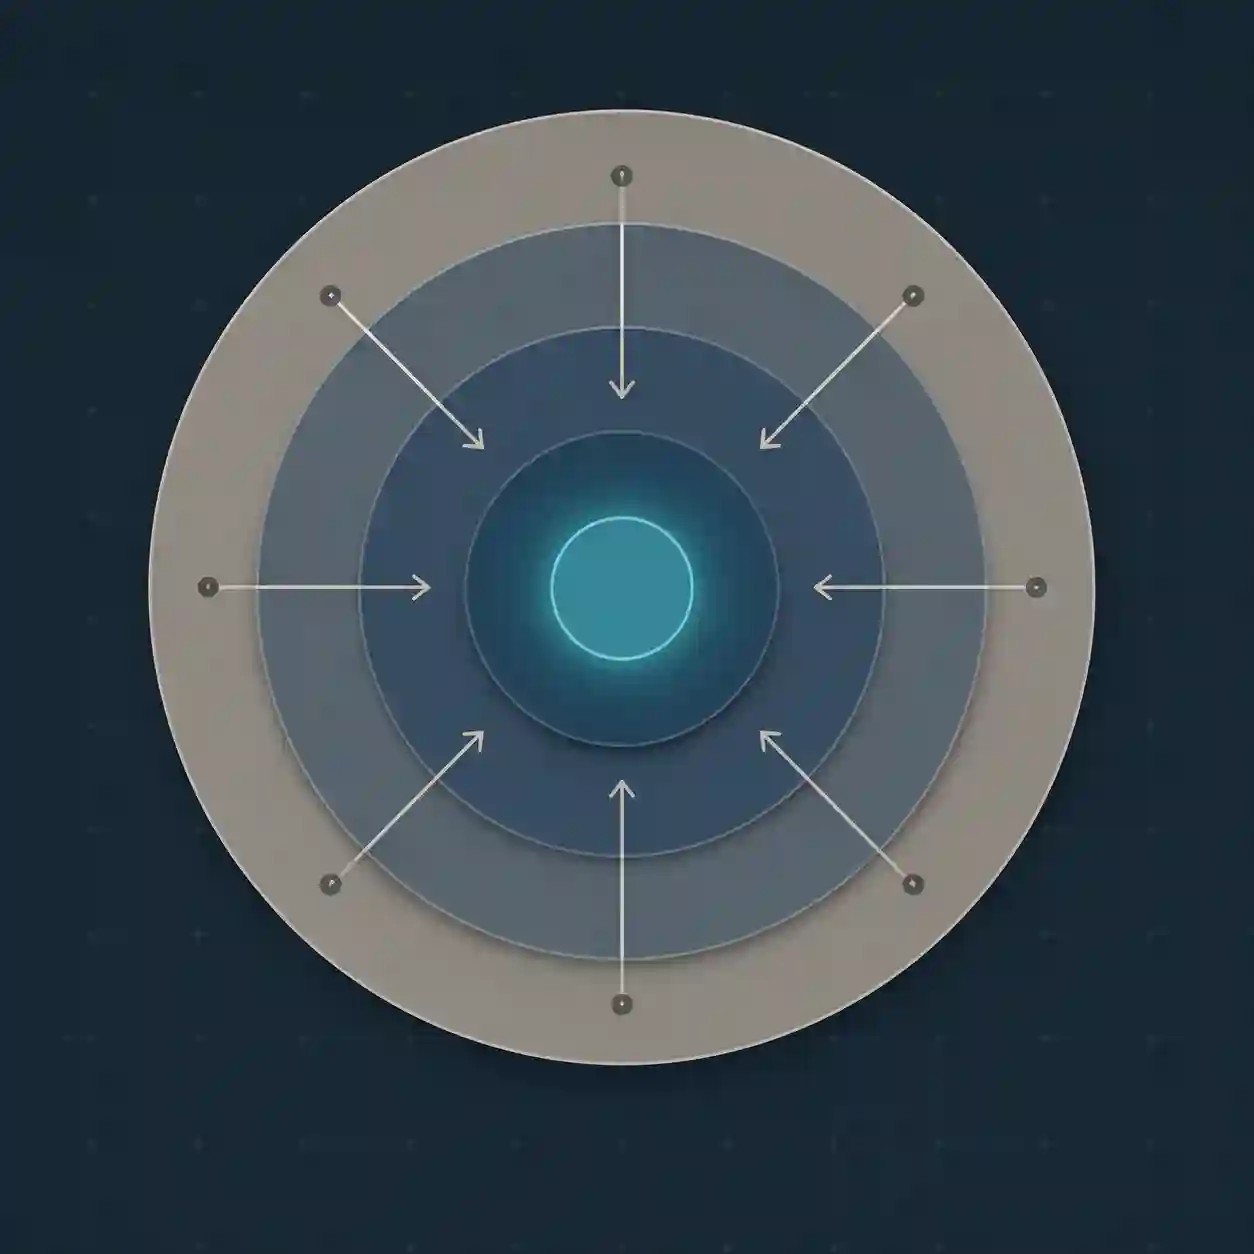
Você decide adotar Clean Architecture no projeto novo. Três semanas depois, tem quatro camadas, doze interfaces e um UseCase que faz uma query simples de banco. O código está "arquiteturalmente correto" e completamente ininteligível para qualquer pessoa nova no time.
Isso não é falha de implementação isolada. É o caminho mais comum de como a arquitetura limpa sai do livro e chega nos projetos reais. Este post resume as vantagens e desvantagens de Clean Architecture, as armadilhas que a transformam em overengineering e os critérios para decidir quando ela compensa. Se o que você procura é um exemplo completo de portas e adaptadores com código, ele está no post irmão sobre arquitetura hexagonal; aqui eu não repito aquele código.
O que a Clean Architecture (arquitetura limpa) realmente diz
Clean Architecture, ou arquitetura limpa, é o modelo que Robert C. Martin descreveu no post The Clean Architecture, de agosto de 2012, e consolidou no livro Clean Architecture: A Craftsman's Guide to Software Structure and Design, de 2017 (no Brasil, Arquitetura Limpa). A ideia central é simples: regras de negócio não devem depender de detalhes. Banco de dados, framework web, interface gráfica, mecanismo de entrega: tudo isso é detalhe. O núcleo do sistema é a lógica que existe independentemente de como ela é exposta ou persistida.
No próprio post, Martin diz que está unificando ideias anteriores: arquitetura hexagonal (ports and adapters), Onion Architecture, Screaming Architecture, DCI e BCE. A representação visual são os círculos concêntricos, de dentro para fora:
- Entities: regras de negócio da empresa. As mais estáveis, sem dependência externa.
- Use Cases: regras de aplicação. Nas palavras dele, orquestram o fluxo de dados de e para as entidades.
- Interface Adapters: controllers, presenters, gateways. Convertem dados entre o formato conveniente para os casos de uso e o formato conveniente para o mundo externo.
- Frameworks & Drivers: banco, framework web, UI, ferramentas. Tudo que é detalhe concreto de implementação.
A Dependency Rule é o único mandamento real: dependências de código-fonte só apontam para dentro. Nada num círculo interno pode saber qualquer coisa de um círculo externo. Use Cases podem depender de Entities, nunca o contrário. Os Interface Adapters dependem dos Use Cases; banco e framework, na camada Frameworks & Drivers, ficam na borda. O que muita gente chama de "camada de infraestrutura" é a soma dessas duas camadas externas, e os Use Cases não importam nada delas.
Frameworks & Drivers  →  Interface Adapters  →  Use Cases  →  Entities
(as setas indicam "depende de": sempre de fora para dentro)
Um detalhe que os diagramas costumam esconder: Martin escreve que os círculos são esquemáticos e que não existe regra dizendo que precisam ser exatamente quatro. O que sempre vale é a Dependency Rule. Se uma seta aponta para fora, a arquitetura quebrou, independentemente de quantas pastas com nomes bonitos você criou.
Vantagens e desvantagens de Clean Architecture em uma tabela
| Vantagem | Desvantagem | |
|---|---|---|
| Testes | Regra de negócio testada sem banco, HTTP ou filesystem | Cada fronteira pede uma interface e pelo menos um fake |
| Framework | Upgrade ou troca de framework não toca o núcleo | Você nada contra a corrente de frameworks MVC "batteries included" |
| Evolução | Mudança de infraestrutura não cascateia para as regras | Mais arquivos e indireção para cada funcionalidade nova |
| Múltiplas entradas | API, worker e CLI reaproveitam o mesmo caso de uso | Em sistema com uma entrada só, a separação não protege nada |
| Time | Fronteiras explícitas facilitam dividir o trabalho | Time sem experiência no padrão erra as fronteiras e cria cerimônia |
A tabela resume o trade-off: as vantagens aparecem quando existe regra de negócio de verdade para proteger; as desvantagens aparecem sempre, desde o primeiro dia.
As vantagens quando fazem sentido
Testabilidade real
É o benefício mais concreto. Quando o caso de uso depende de abstrações em vez de implementações, você testa a lógica de negócio sem banco rodando. Em Python, a abstração pode ser um Protocol, declarado junto do caso de uso, porque é ele quem precisa dela (é a inversão de dependência, o "D" dos princípios SOLID):
from typing import Protocol

class PedidoRepository(Protocol):
    def buscar(self, pedido_id: str) -> Pedido: ...
    def salvar(self, pedido: Pedido) -> None: ...

class Notificador(Protocol):
    def notificar(self, pedido: Pedido) -> None: ...

class ProcessarPedido:
    def __init__(self, repo: PedidoRepository, notificador: Notificador):
        self.repo = repo
        self.notificador = notificador

    def executar(self, pedido_id: str) -> None:
        pedido = self.repo.buscar(pedido_id)
        pedido.confirmar()  # regra da entidade: só pedido pendente confirma
        self.repo.salvar(pedido)
        self.notificador.notificar(pedido)
No teste, entram fakes no lugar do banco e do e-mail:
def test_confirma_salva_e_notifica(self):
    repo = InMemoryPedidoRepository(Pedido("p-1"))
    notificador = FakeNotificador()

    ProcessarPedido(repo, notificador).executar("p-1")

    self.assertEqual(repo.buscar("p-1").status, "confirmado")
    self.assertEqual(notificador.enviados, ["p-1"])
Rodei o exemplo completo (entidade Pedido como dataclass, os dois fakes e dois testes, incluindo o caso em que um pedido já confirmado não pode ser notificado de novo) com unittest no Python 3.12: os dois passam sem container, sem seed e sem rede. InMemoryPedidoRepository e FakeNotificador são fakes, implementações simples que funcionam de verdade, e não mocks com expectativa de chamada; a diferença está explicada em mock, stub, fake e spy.
Em sistemas com lógica de negócio complexa (cálculo de financiamento, regras fiscais, precificação dinâmica), isso separa uma suíte que todo mundo roda localmente de uma suíte que ninguém executa porque precisa subir meio ambiente.
Independência de framework
O framework é um detalhe de entrega. Com a Dependency Rule respeitada, trocar Flask por FastAPI ou Express por Fastify não toca a regra de negócio. Na prática, trocar de framework é raro. O que acontece com frequência é o framework lançar uma versão major com breaking changes, e aí ter o núcleo isolado transforma a migração em algo cirúrgico.
Longevidade do código
Sistemas de negócio evoluem: regras de cálculo mudam, canais de entrega aparecem, integrações externas são trocadas. Com as regras isoladas, mudança de infraestrutura não cascateia para o núcleo. O post sobre Clean Code sem dogmas mostra como acoplamento implícito vira bug de manutenção no nível da função; Clean Architecture ataca o mesmo problema no nível dos módulos.
As desvantagens e armadilhas reais
Overengineering em projeto pequeno
É o erro mais comum. Clean Architecture tem custo de setup: mais arquivos, mais indireção, mais abstração para manter na cabeça. Num CRUD simples ou numa API com dez endpoints, esse custo não se amortiza.
Um script de automação interna, um webhook que processa eventos, uma ferramenta administrativa: nenhum desses casos justifica quatro camadas. Justifica código direto, bem nomeado, com testes onde há lógica não trivial. Para esses casos, o modelo de controller, service e repository costuma ser suficiente.
A pergunta certa antes de adotar: "a lógica de negócio desse sistema vai crescer e se diversificar com o tempo?" Se a resposta for não, Clean Architecture é overengineering com nome bonito.
A ilusão das pastas
O erro mais frequente em bases de código que "usam Clean Architecture" é confundir estrutura de pastas com arquitetura.
src/
  domain/
    user.py
  use_cases/
    create_user.py
  infrastructure/
    user_repository.py
  controllers/
    user_controller.py
Ter essas pastas não garante nada. Se use_cases/create_user.py importa diretamente infrastructure/user_repository.py em vez de depender de uma abstração, a Dependency Rule está quebrada, qualquer que seja o layout de diretórios. Arquitetura limpa não é um layout de filesystem; é a direção das dependências no código-fonte. Um jeito barato de vigiar isso é olhar os imports de cada PR que mexe em use_cases/: qualquer import de infrastructure/ ali é uma seta apontando para fora.
Use cases anêmicos
Um sintoma comum de Clean Architecture mal aplicada são casos de uso que não fazem nada além de delegar:
class GetUserById:
    def __init__(self, repo: UserRepository):
        self.repo = repo

    def execute(self, user_id: str) -> User:
        return self.repo.find_by_id(user_id)  # delegação pura, sem lógica
Aqui é opinião, não regra do livro: na minha experiência, um caso de uso assim raramente se paga. É indireção sem benefício, e o controller poderia chamar o repositório (ou um serviço de consulta) direto. Existe um argumento legítimo do outro lado: em times grandes, manter toda entrada passando por um caso de uso dá consistência, um lugar óbvio para autorização e logging, e evita a discussão "esse aqui merece ou não". Se o time escolheu essa consistência de propósito, tudo bem. O problema é quando dezenas de casos de uso como esse aparecem por inércia, e o projeto paga toda a complexidade do padrão sem colher nada.
Mapeamento excessivo de dados
Clean Architecture frequentemente leva a DTOs em cada fronteira. Isso faz sentido quando os formatos realmente divergem: o que vem do banco não é o que vai para o cliente, e o que chega do cliente não é o que o domínio processa. Mas quando todos os objetos têm os mesmos campos, você acaba com cinco classes quase idênticas e código de mapeamento que é vetor garantido de bug (um campo novo esquecido em uma das cinco).
Regra prática: mapeie nas fronteiras onde o contrato realmente muda. Não crie objetos de mapeamento por princípio.
Quando usar Clean Architecture
Clean Architecture compensa quando dois ou mais destes fatores estão presentes:
- Lógica de negócio complexa: regras que mudam independentemente da infraestrutura, que precisam de testes rápidos, que vão além de CRUD.
- Sistema de vida longa: vai ser mantido e evoluído por anos, provavelmente por pessoas diferentes.
- Múltiplas interfaces de entrega: API REST, workers assíncronos, CLI, webhooks, todos acessando o mesmo núcleo.
- Time com experiência no padrão: arquitetura limpa bem executada exige que o time entenda o porquê das regras. Quem aplica pela primeira vez erra as fronteiras e cria acoplamento onde não devia.
Se o projeto tem um só desses fatores, desconfie de overengineering. Se não tem nenhum, é overengineering. E vale a heurística do post de hexagonal: não precisa aplicar o padrão inteiro em todo lugar. Isolar só o módulo de regras que dói (precificação, cálculo fiscal) e deixar o resto como CRUD direto é uma decisão de arquitetura tão válida quanto as quatro camadas.
Perguntas frequentes
Clean Architecture é a mesma coisa que arquitetura hexagonal?
Não, mas defendem a mesma regra: dependências apontando para o núcleo. Martin cita a hexagonal de Alistair Cockburn como uma das fontes que ele unificou; a diferença é que a Clean Architecture nomeia camadas concêntricas, enquanto a hexagonal organiza o desenho por portas de entrada e de saída. A comparação completa, com exemplo em PHP, está no post sobre arquitetura hexagonal.
É possível migrar um projeto legado para Clean Architecture?
Sim, mas de forma incremental. Identifique os módulos com mais lógica de negócio e mais mudanças e extraia abstrações nessas fronteiras primeiro. O resto do sistema pode continuar como está até a refatoração fazer sentido economicamente. Tentar aplicar arquitetura limpa em todo o legado de uma vez é receita de projeto parado.
Clean Architecture funciona com Django ou Rails?
Funciona, mas exige disciplina. Frameworks MVC convencionais incentivam colocar lógica no model ou no controller. Dá para criar uma camada de casos de uso separada e usar o ORM como implementação do repositório, só que você vai nadar contra a corrente do framework. Em projeto Django pequeno, provavelmente não vale a fricção; em sistema grande com regra de negócio real, a separação paga.
Qual a diferença entre Clean Architecture e DDD?
São complementares. DDD trata de como modelar o domínio: agregados, entidades, value objects, bounded contexts. Clean Architecture trata de como organizar as dependências entre camadas. Dá para usar os dois juntos, e o post sobre DDD para projetos pequenos mostra quanto de DDD cabe num projeto que não é gigante.
Arquitetura limpa é sobre dependências, não sobre pastas
O único critério que importa é a Dependency Rule. Todas as outras decisões (quantas camadas, quantas interfaces, como nomear as pastas) são consequência de para onde as dependências apontam. Um projeto com três arquivos que respeita a regra tem arquitetura limpa; um projeto com quarenta pastas e casos de uso importando repositórios concretos tem só a aparência.
Antes de adotar, pergunte se o sistema tem complexidade de negócio suficiente para pagar o custo de indireção. Se tem, o investimento se paga com testes rápidos e mudanças de infraestrutura que não vazam para as regras. Se não tem, código simples, direto e bem testado é a arquitetura certa. Para vigiar a regra no dia a dia, eu reviso os imports de cada mudança em casos de uso; colar o antes e o depois no Comparador de Código deixa óbvio quando uma dependência nova cruzou a fronteira para fora.
- 01 Como investigar falta de espaço em disco no Linux Um método de diagnóstico para descobrir por que o disco está cheio: df para achar o mount, du para o diretório, e os casos que confundem como inodes e arquivos deletados.
- 02 Permissão 755, 775 e 644 no Linux: o que significa (chmod) 755 para pastas e scripts, 644 para arquivos, 775 quando o grupo também grava: veja o que cada número do chmod libera e por que trocar o 777.